PPO
PPO与TRPO旨在解决相同的问题:在策略梯度定理的步长
PPO也继承了TRPO的核心思想:引入重要性采样,提高样本效率;同时,通过某种方式来约束新旧策略间的差异不要太大。
不同的是,TRPO 试图用复杂的二阶方法解决这个问题(对目标函数采取一阶近似,约束条件采取二阶近似),然而PPO采用了一系列的一阶方法(Clip),它们使用一些其他技巧来使新策略接近旧策略。PPO在算法上更加简单,且效果不输于TRPO算法的效果。
回顾一下,TRPO算法对以下目标函数进行优化问题的求解:
这里,
是更新之前的策略参数向量, 是在时刻 的优势函数估计,期望 是在采样和优化之间交替的算法中,有限批次样本的经验平均值。求解的过程采用到了共轭梯度和线性搜索的方式。 TRPO在目标函数中,另外增加了一个约束条件。在推导该式的过程中, 涉及到了一个将KL散度****作为惩罚项的极值问题,转化为KL散度作为约束条件的优化问题的过程。将KL散度作为惩罚项的问题,公式如下:
然而,因为权重难以选择和调整的问题,因此TRPO并没有采取这样的方式进行目标函数的设定。
PPO-惩罚(PPO1)
PPO-惩罚(PPO1)用拉格朗日乘数法直接将KL散度的限制放入了目标函数,因此变成了一个无约束的优化问题,在迭代的过程中不断更新KL散度前的系数。这里,使用几个阶段的小批量SGD,优化KL惩罚目标,其更新方式即为公式(2)
为了对
-
如果
,则 。 -
如果
,则 -
否则,
保持不变。 在这里,更新的 用于下一次迭代时的参数更新。
PPO这里使用了GAE进行计算
PPO-截断(PPO2)
PPO2在限制新的策略参数与旧的策略参数的距离上,相比于PPO1更加直接。区别于PPO1使用KL散度的方式进行限制,PPO2直接在目标函数上进行限制:
其中,
-
称为概率比,易得 -
指的是将 限制在 的范围内。 即把 限制在 内
-
为超参数,表示进行截断操作的范围,一般取 。
这样,就始终保证了新旧策略的比值在
PPO2中,较为精妙的一点是在
如下面两张图所示
-
是绿色的线; -
是红色的线;
在绿色的线与红色的线中间,我们要取一个最小的结果。
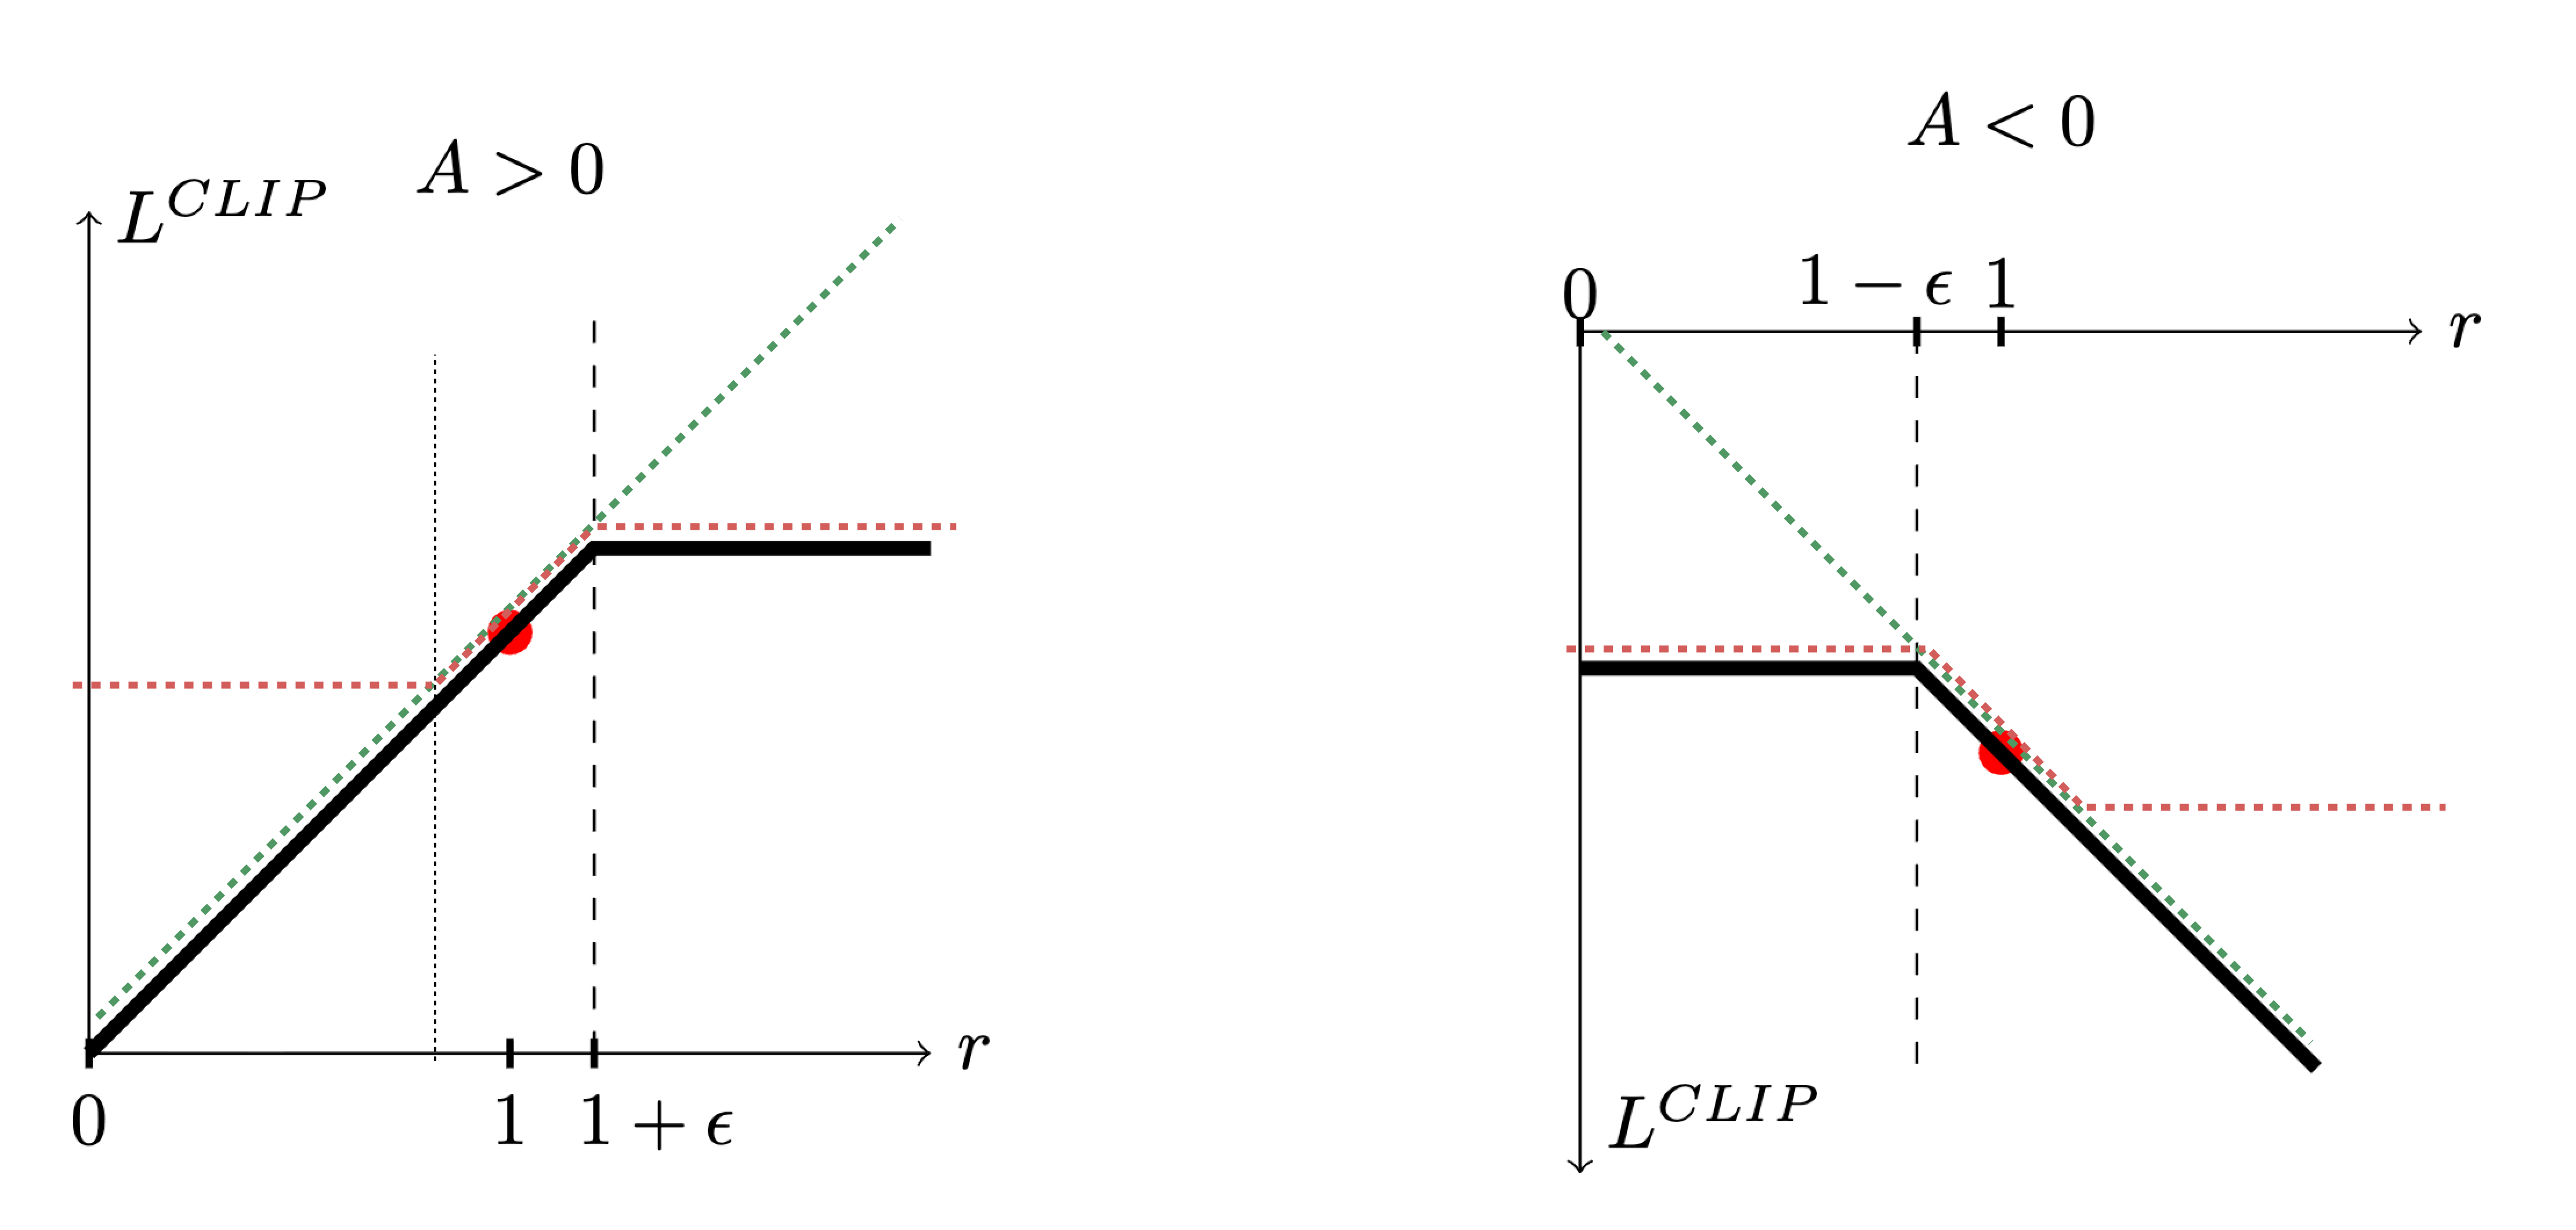
如图所示,假设前面乘上的项
下面来做一个详细的讨论。
-
如果
,也就是某一个状态-动作二元组相比于状态价值函数 更好,我们就希望增大这个状态-动作二元组的概率。也就是,我们想让 越大越好,但它与 的比值不可以超过 。如果超过 ,新策略与旧策略之间的差距就会过大而产生问题。所以在训练的时候,当 被训练到 时,训练就会停止。 -
如果
,也就是某一个状态-动作二元组相比于状态价值函数 更差,那么我们希望把 减小。如果 比 还大,那我们就尽量把它减小,减到 是 的时候停止, 此时不用再减得更小,即新旧策略之间的差距不会过大。